她带进课堂的问题:每一次新需求,都从零开始
速品食品 2007 年成立于江苏昆山,服务喜茶、霸王茶姬、瑞幸、必胜客等新茶饮与烘焙品牌。王慧程把它交给课堂的第一份材料,是一份被四条痛点填满的《场景描述》——每一条都不是抽象概念,而是一笔能算出来的账。
四条痛点,四种代价
- 研发效率低、多需求并发能力丧失:单客户打样周期 1—2 天;需求超过 5 个,只能排队或放弃;小客户因响应慢转向竞对,年流失率可能增加 15%—30%。
- 成本高昂、原料损耗大:每轮试验都要实物打样,年损耗价值数十万甚至上百万元;赶工期时降低选料标准,最终产品竞争力反而下降。
- 质量不稳定、客户信任度降:多任务切换导致感官疲劳,后期评判标准飘忽,寄样与前期承诺不符,反复修改。
- 经验依赖强、抗风险能力弱:核心配方逻辑锁在少数老员工脑中;关键人离职,配方失传;新人培养周期 1—2 年。
王慧程的判断很直接:这四条痛点的共同根因,是「知识不在库里,只在人脑里」。所以她选定的选题不是做一个更快的表格工具,而是把原料特性、历史配方、感官评价、工艺参数、客户反馈全部结构化、数字化,做成一个可被 AI 工作伙伴调用的知识资产库。
选题过程:从「翻台账」到「把知识交出去」
课程里反复被强调的一条原则是「案例驱动、产出物导向」——不先讲概念,而是先问:你明天回到公司,最想让哪一件事不再从零开始?对王慧程来说,答案是「选型」。她把这个环节拆成了可验证的路径:
她定义的产品研发流程(docx 原文)
- 01 需求结构化
客户的风味、成本、应用需求,先变成 AI 能读懂的坐标(如「香高、甜花、尚浓爽」)。
- 02 样品库检索匹配
在 276 条实测样品库里做三轴条件命中,而不是靠翻纸质记录与记忆。
- 03 拼配方案与成本核算
给出配方与批量参考价,方案阶段即可公式直算,不再等滞后的财务核价。
- 04 数据回流
打样测评数据回流样品库,让下一次检索更准——形成一个能自己变强的闭环。
关键技术:让「对话」直接产出结构化报告
她的 AI 工作伙伴不是「聊天机器人」,而是一个能被调用、有输入有输出、能溯源的专业技能。她给技能设定的输出契约是结构化的:需求五维画像、三约束选型、库存联动、配方推荐、证据分层。下面三张是系统实跑的真实结果。
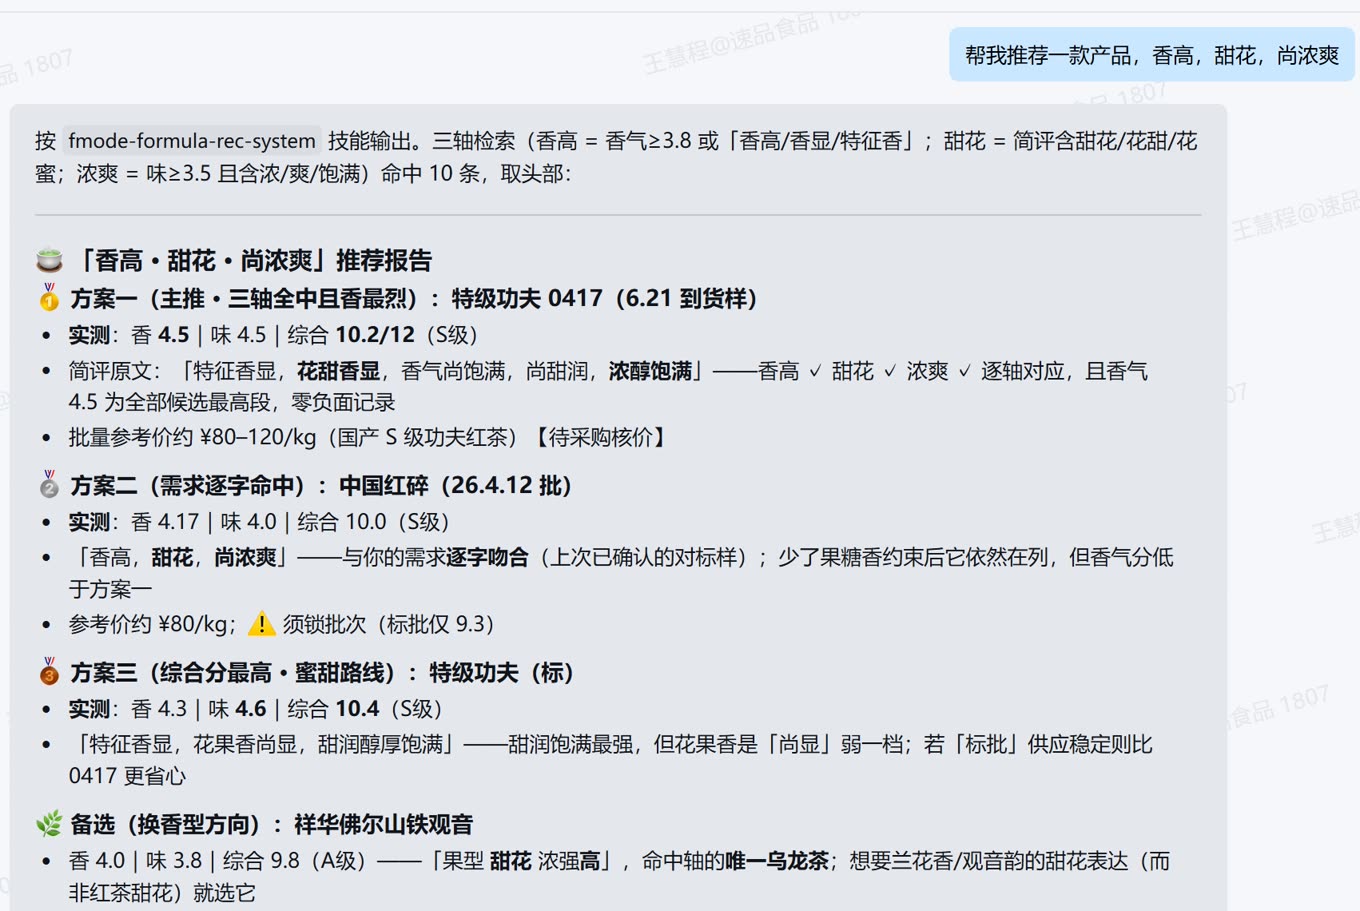
值得注意的是报告里的「引文溯源」:每条推荐都附简评原文(如「特征香显,花甜香显,香气尚饱满,尚甜润,浓醇饱满」),并逐轴打勾。这意味着研发人员可以直接核对 AI 的判断依据,而不是盲信一个黑箱结论。
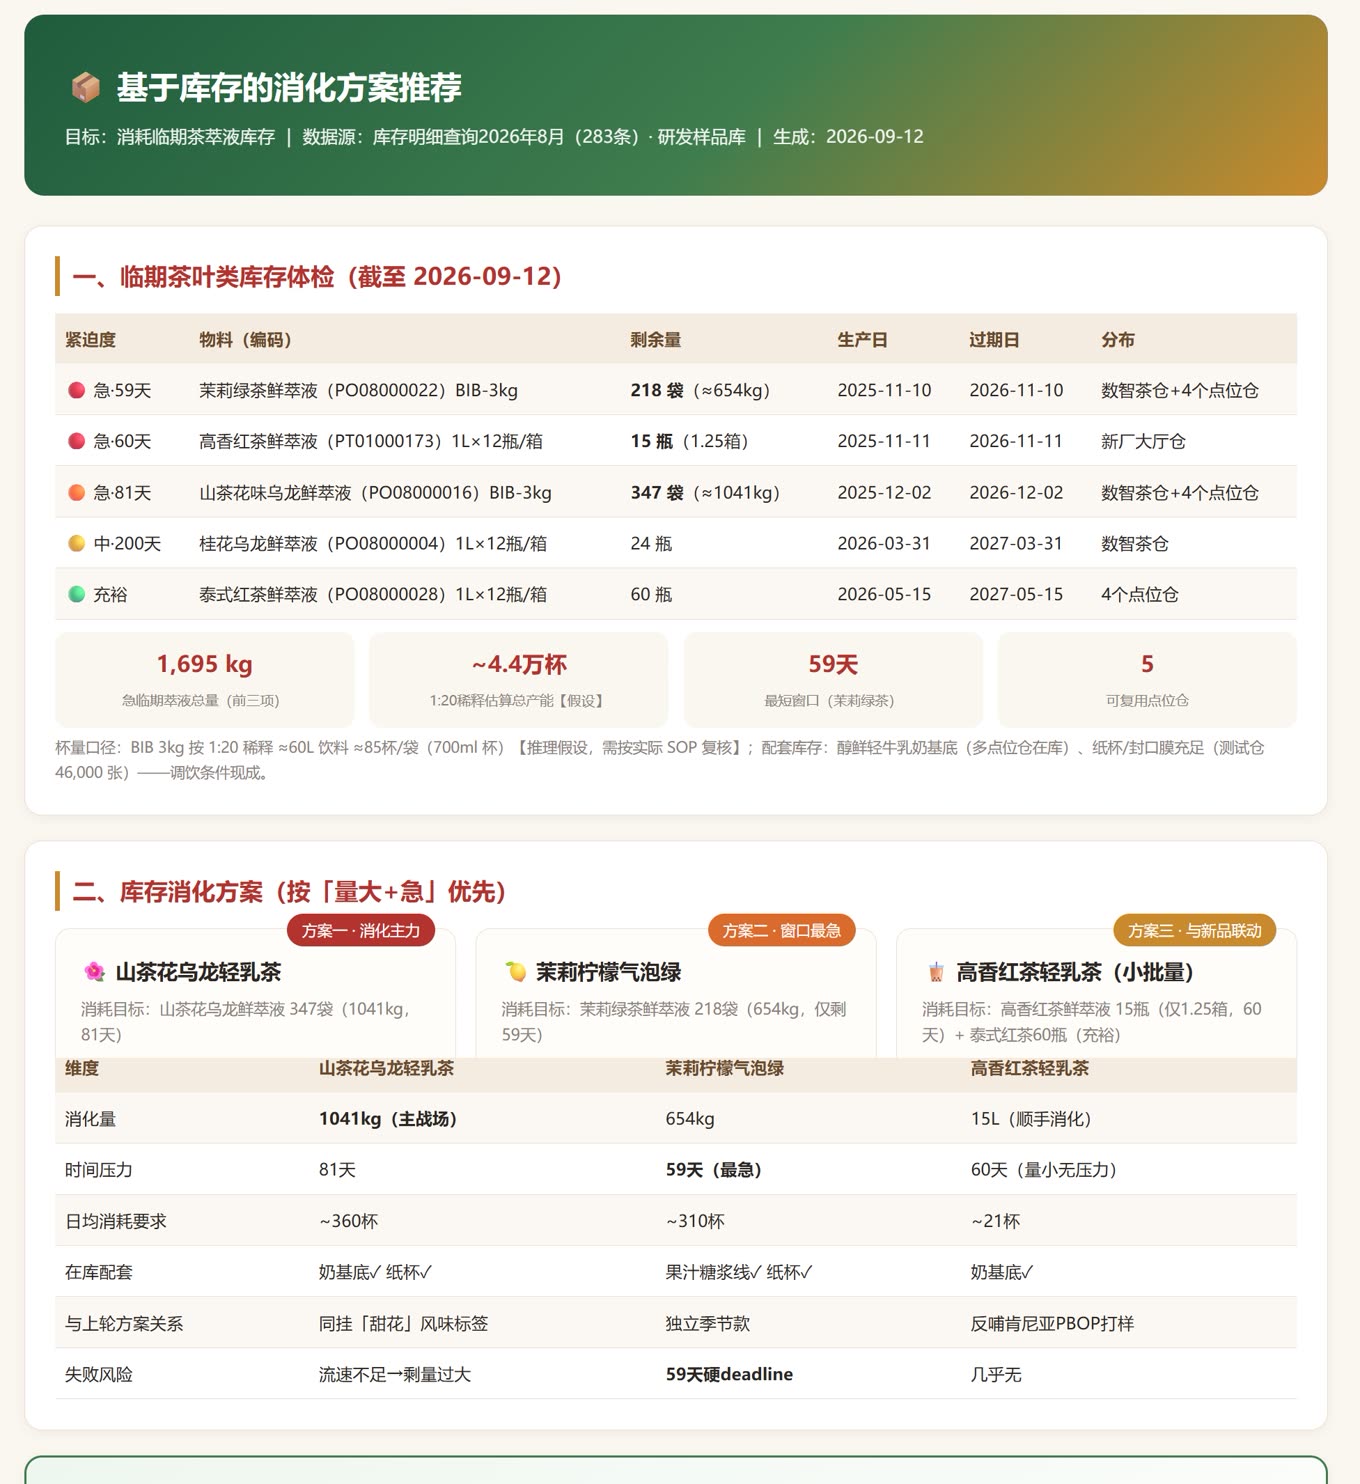
供应链库存压力,被转化成了研发排产决策——临期原料不再只是财务表上的损耗数字,而是「这周该出哪款新品」的输入。
细节里藏着的工程自觉:证据分层与质量自检
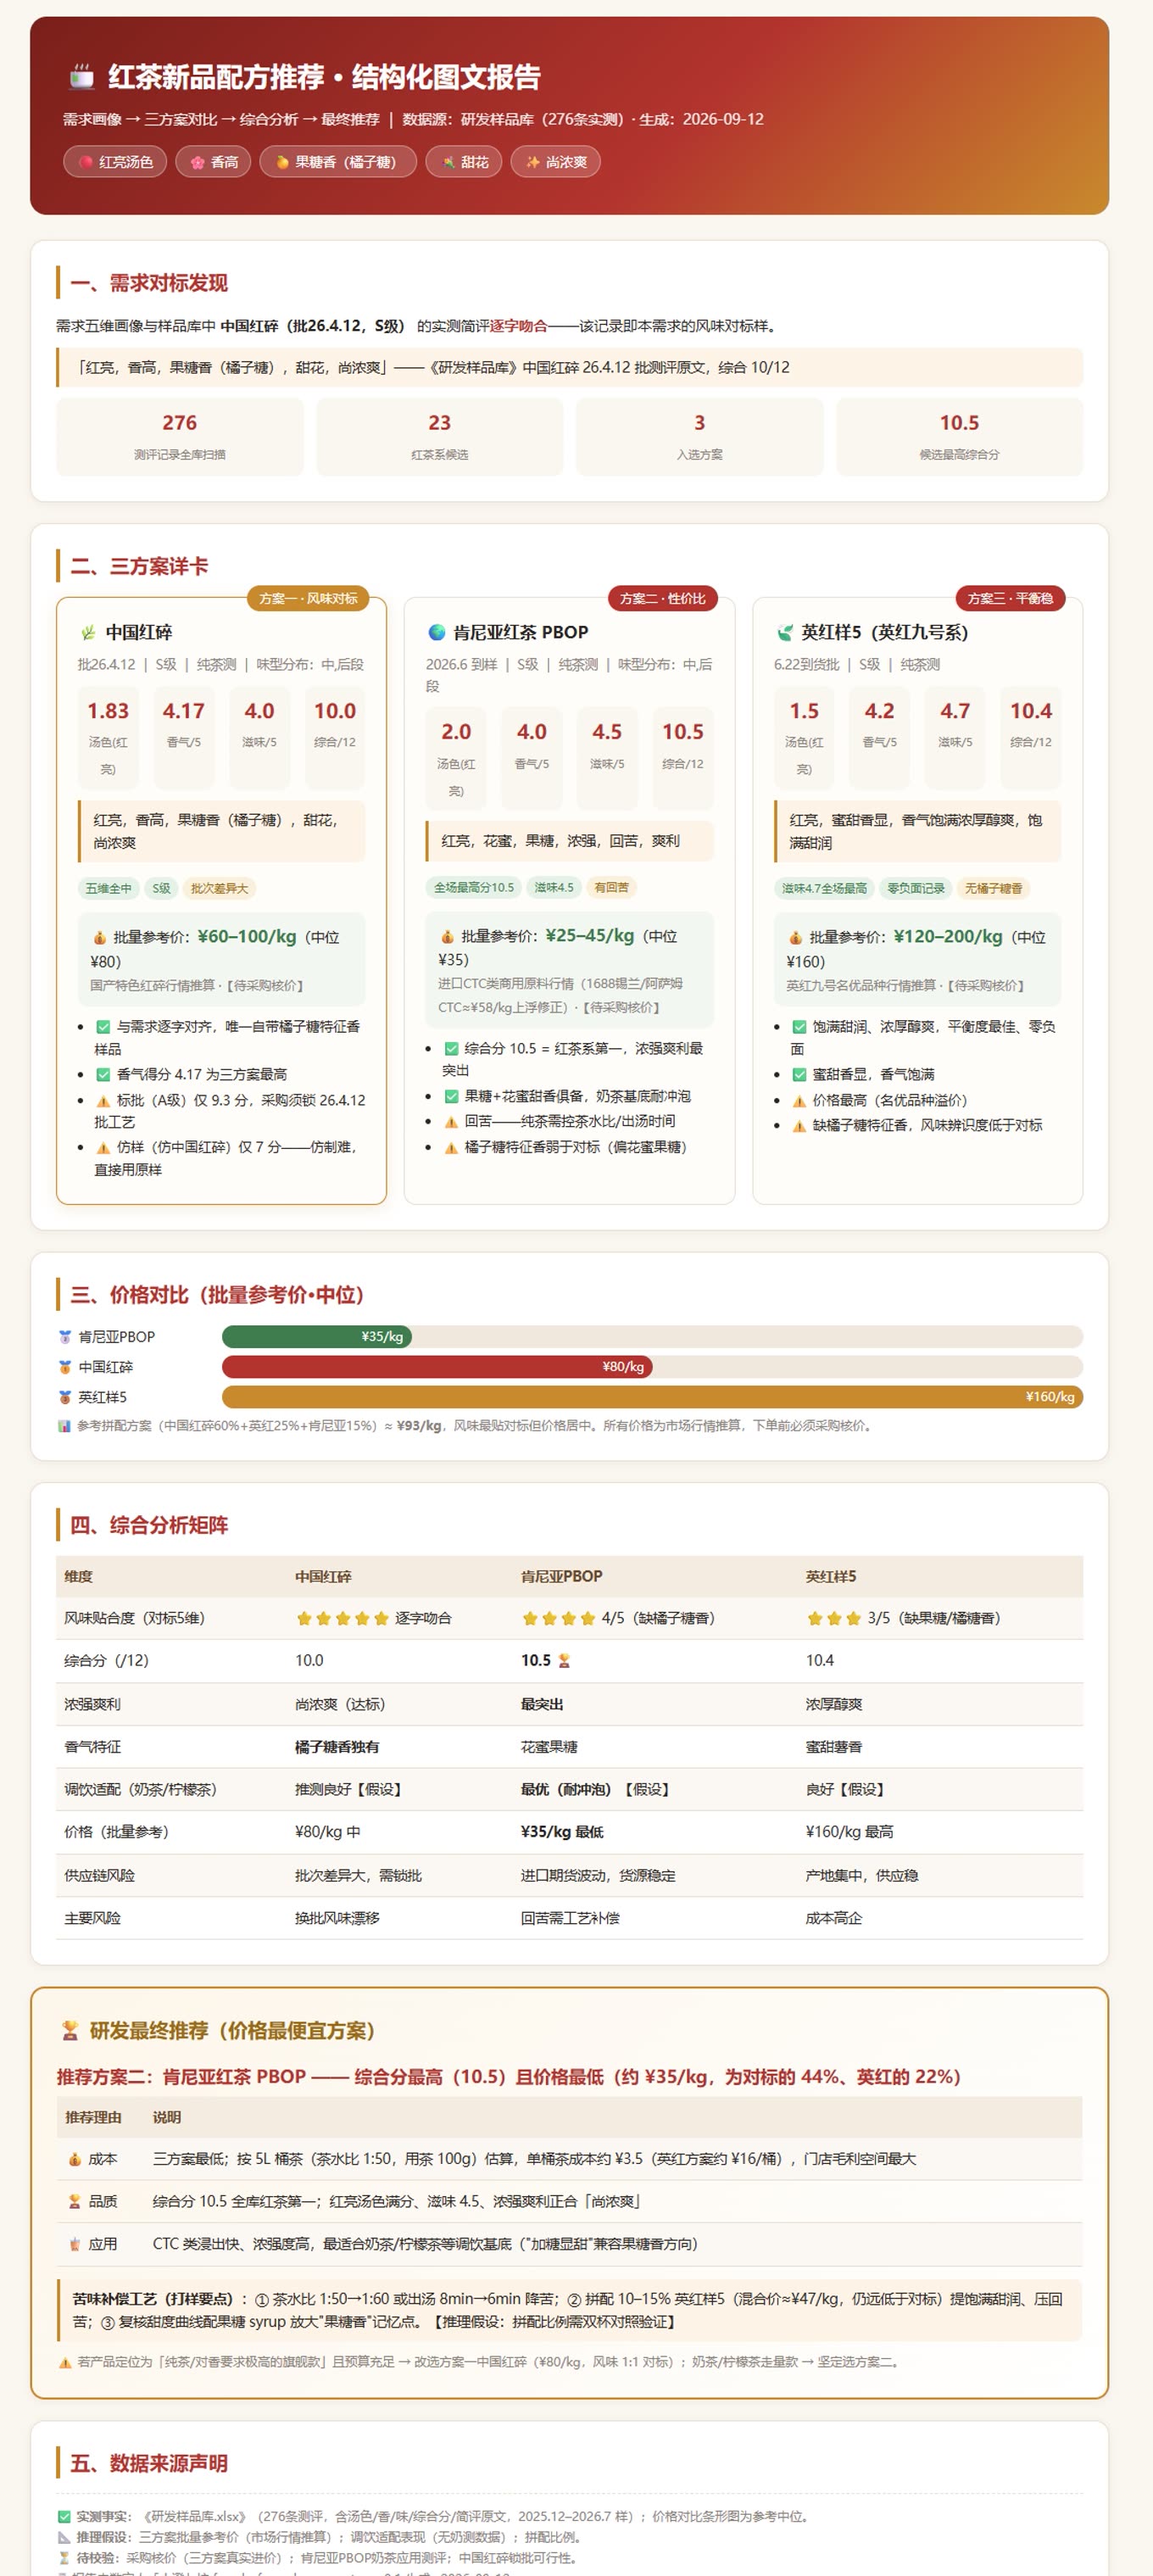
这份报告最不像「科技演示」、最像「真交付」的地方,是它的谨慎。报告对每一条结论做了三层标注:实测事实、推理假设、待核验。所有涉及价格的数字都注明「待采购核价」,涉及产能的结论标注「【假设】」。
首次实跑的全流程报告里,王慧程还让 AI 工作伙伴做了质量自检,主动列出 4 条发现:成本口径疑似不一致、源表缺三列、样品库缺商业字段、以及一条意外收获——模拟需求与在售 4 款产品高度一致,可复用现有供应链。页脚写着:「全部原料与数据可溯源,假设项显式标注,王慧程复核」。
学习心得:从「形」到「魂」
这两天真正的突破不是工具,而是方法论——技能 = 知识库 + 规则 + 工具链 + 回流闭环。
—— 王慧程 · 课堂复盘原文
在复盘材料里,王慧程用「从形到魂」形容自己的变化:一开始以为学会一个对话工具就够了,两天的学习让她意识到,真正值钱的是把业务知识结构化、把规则固化、让工具链与回流形成闭环的能力。她写下的一句话,也正好呼应了未来飞马在课堂上反复讲的判断——「产品研发助手跑通之后证明了:AI 不是玩具,能出活、能交付。」
她给自己企业提炼的护城河公式是:懂 AI 边界(不盲目追新)+ 懂业务(知道哪里值钱)+ 懂落地(把系统化能力沉淀下来)。这恰恰是未来飞马认为未来全栈人才的核心画像——不是「会写提示词的人」,而是「能把 AI 变成企业产能的人」。